最近我在研究如何替中文文章標註注音,找到 bpmfvs 注音 IVS 字型規格提供的讀音選擇工具。對這類工具來說,顯示注音只是其中一件事,更麻煩的是同一個字有不同讀音,而且選完之後,還要能複製到其他軟體,甚至更換字型。
我先從網頁程式往下追,確認它使用 JavaScript 與 jQuery,再沿著詞庫產生器與字型建置程式看了一遍。這才釐清整套工具的分工:JavaScript 根據詞庫協助選音,文字裡的異體字選擇子負責保存選擇,注音字型負責把結果畫出來。這三件事分開理解,很多看似神奇的行為就能解釋清楚。
這篇文章會從實際操作開始,接著拆解 IVS 編碼、詞庫格式、前端選音流程與 Ruby 資料產生器,最後整理我實測遇到的規則衝突與 Unicode 邊界。文中也會區分專案規格、目前程式的實作,以及還需要人工確認的地方。
先分清楚工具、文字與字型的責任
bpmfvs 這個儲存庫同時包含注音字型規格、字型建置程式、讀音資料與網頁工具。讀音選擇工具是其中的 ime/ 目錄,不能把整個專案都視為一個 JavaScript 應用程式。
| 層次 | 負責什麼 | 主要檔案 |
|---|
| 選音介面 | 標記多音字、比對詞彙、讓使用者選音 | ime/index.html、ime/ime.js |
| 文字編碼 | 把選擇結果存成漢字與異體字選擇子的序列 | ime/ime.js 中的 vsbase 與選音事件 |
| 注音字型 | 依文字序列選出漢字與注音組合的字形 | ime/BpmfZihiKaiStd-Regular.ttf、make_font.rb |
| 資料準備 | 整理讀音、產生瀏覽器使用的詞庫 | phonetic/make_ptable.rb、ime/gen_jsdb.rb |
一般選音結果不是圖片,也不是在每個漢字旁插入一串可見的注音文字。選擇工具主要修改文字序列,實際看到的注音外觀由字型提供。因此,把結果換成不支援此規格的字型,可能只剩漢字;這不代表選音資訊一定已經消失。
先用一段文字操作一次
一般使用者可以從專案提供的線上入口開始,操作說明在 guide/README.md。如果要研究本文所述的程式版本,我建議直接在 checkout 中啟動本機 HTTP 服務:
git clone https://github.com/ButTaiwan/bpmfvs.git
cd bpmfvs
# 要重現本文版本時才需要這一步
# git checkout fa20c2bb5e2986856974f00c93a662d0805c92a0
python3 -m http.server 8765 --bind 127.0.0.1
接著開啟 http://127.0.0.1:8765/ime/,輸入以下文字:
會計和牛仔一起開會。
- 按下開始,工具會將文章轉成可逐字選擇的編輯畫面。
- 觀察已猜測的多音字,例如會計的會、牛仔的仔。
- 點選文字或下方箭頭切換多音字,再從候選列選擇讀音。
- 按下完成,工具會把結果放回文字框並選取,供使用者複製。
- 貼到目標軟體後,選用符合 bpmfvs 規格的注音字型,再確認顯示結果。
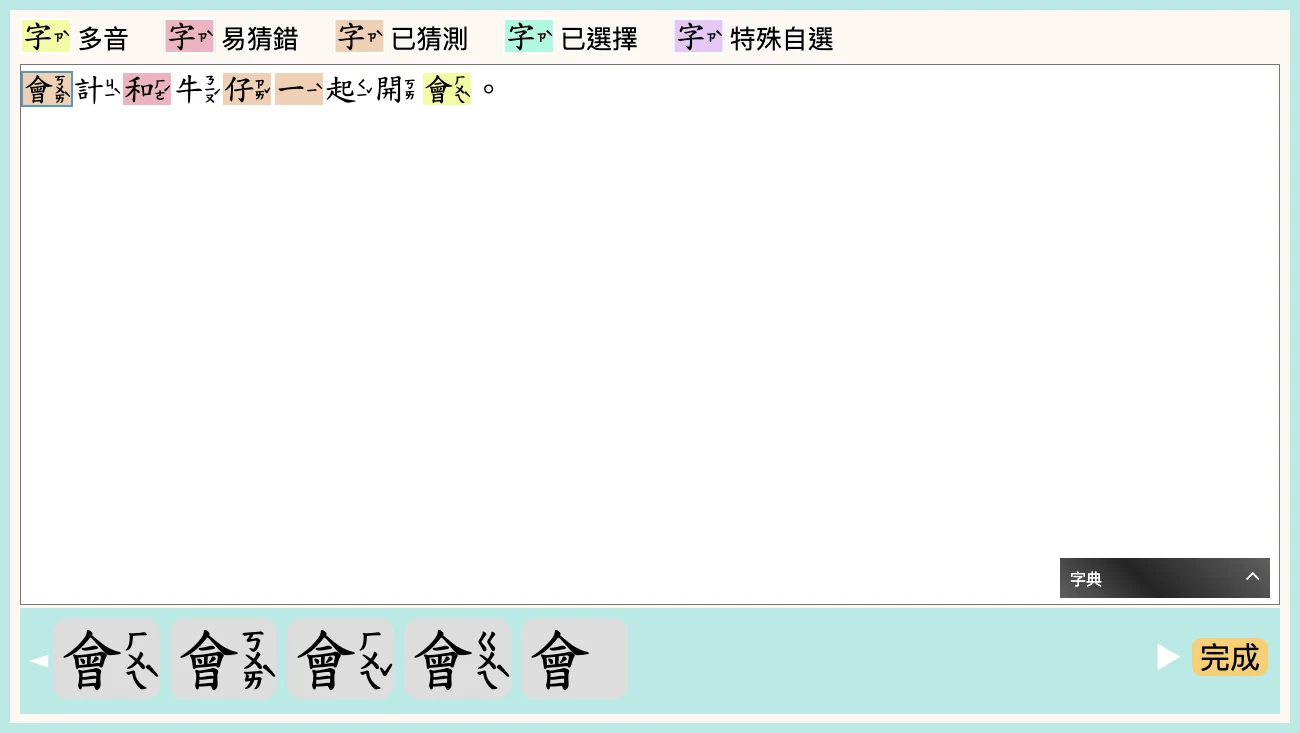
目前畫面的黃色表示多音字,粉紅色表示易猜錯,橘色表示已猜測,綠色表示已選擇,紫色表示特殊自選。這些底色是介面狀態;真正會隨純文字帶走的是選擇子,不是背景顏色。
README 提供直接開啟 HTML 的使用方式;我在本文用 HTTP 服務實測,讓字型、JavaScript 與字典 iframe 都由同一個來源載入,避免把本機檔案存取限制混進功能驗證。這個服務只提供靜態檔案,沒有在伺服器替文章選音。
理解 IVS:讀音怎麼藏在文字裡
Unicode 的 variation sequence 由基底字元與其後的 variation selector 組成。bpmfvs 借用這種字形選擇機制,將不同讀音做成不同字形,再以漢字後方的選擇子切換。機制背景可參考 Unicode 的 Variation Sequences FAQ。
在本文檢查的讀音表中,會字的前幾個讀音依序是:
| 讀音 | 文字序列 | JavaScript 表達式 |
|---|
| ㄏㄨㄟˋ | U+6703 | '會' |
| ㄎㄨㄞˋ | U+6703 U+E01E1 | '會\u{E01E1}' |
| ㄏㄨㄟˇ | U+6703 U+E01E2 | '會\u{E01E2}' |
| ㄍㄨㄟˋ | U+6703 U+E01E3 | '會\u{E01E3}' |
這裡有個容易看錯的地方:U+E01E0 在此專案表示注音留白,不是第一讀音。第一讀音直接使用沒有選擇子的漢字;第二讀音才加上 U+E01E1。
讀音編號的意義來自 bpmfvs 的資料表與字型約定。不能把它解讀為 Unicode 規定 U+E01E1 一律代表某種發音。Unicode 官方也區分標準化或已登錄的變體序列與自行約定的序列;本專案使用 IVS 技術,不等於它的全部注音對應已獲 Unicode 標準化。
用 JavaScript 看見不可見的選擇子
光看螢幕上的字,很難確定資料有沒有保留。我會直接列出碼位:
const selected = '會\u{E01E1}';
const codePoints = Array.from(selected, ch =>
  'U+' + ch.codePointAt(0).toString(16).toUpperCase()
);
console.log(codePoints); // ['U+6703', 'U+E01E1']
console.log(selected.length); // 3,UTF-16 code unit 數量
console.log(Array.from(selected).length); // 2,Unicode 碼位數量
這個範例也說明了 JavaScript 的陷阱:選擇子在 BMP 之外,需要兩個 UTF-16 code unit,因此 length 不等於使用者看到的字數。反過來說,Array.from() 雖然能逐碼位迭代,也不會自動把漢字與選擇子合成一個編輯單位。
查看字型如何把編碼畫成注音
前端候選列沒有替每個字另外排一組注音 HTML。它只是產生同一漢字加不同選擇子的文字,再套用網頁載入的注音字型。因此,候選列本身也是這套字型規格的示範。
往 make_font.rb 的 create_zhuyin_glyphs 看,可以看到程式將漢字字形與注音字形組合,第一讀音寫入一般的 cmap,後續讀音則寫入 cmap_uvs。OpenType 對變體序列的對應機制可參考 cmap format 14。
這也解釋了更換字型仍能保持選音的前提:兩套字型必須對相同漢字與選擇子,使用相同的讀音順序。一般中文字型不必遵循這個約定,不同年代的字型也必須確認是否收錄所需字形。
| 方式 | 選擇資訊放哪裡 | 跨軟體複製時要注意什麼 |
|---|
| 傳統多字型方案 | 每個字使用的字型名稱 | 更換整篇字型時,原本的區分可能失去 |
| bpmfvs 的 IVS 方案 | 文字內的異體字選擇子 | 軟體須保留文字序列,字型須有相符映射 |
| GSUB 文體集 | 應用程式保存的 OpenType 排版設定 | 純文字複製不包含這類設定 |
專案字型也提供 GSUB 文體集,但這個網頁工具的主要選音輸出採 IVS,沒有替 Word 或 Illustrator 設定文體集。兩條路徑不要混為一談。
找到詞庫:三份資料各有不同用途
我追程式時,最先需要釐清的是詞庫到底指哪個檔案。實際上,這裡至少有三份不同角色的資料:
| 檔案 | 保存內容 | 何時使用 |
|---|
phonetic/phonic_table_Z.txt | 漢字、碼位、來源群組與依序排列的讀音 | 產生字型與瀏覽器詞庫時 |
ime/poyin_db.txt | 各字各讀音對應的詞彙規則 | 人工維護,再交給 Ruby 轉換 |
ime/poyin_db.js | 可直接載入的 JavaScript 資料物件 | 網頁執行時 |
完整讀音表的來源策略記錄在 phonetic/README.md,涵蓋專案採用的教育部讀音資料、化學用字、全字庫與新酷音交集,以及人工補充等。這是專案的資料整理策略;本文不將其中對舊版審訂表狀態的歷史敘述,當成目前教育政策的結論。
讀音順序是相容性契約。如果把第二、第三讀音交換,舊文章裡原本的選擇子仍然存在,顯示出的發音卻會改變。因此,專案的 make_ptable.rb 會參考先前釋出的讀音表,維持既有順序,將新增讀音附加在後面。
讀懂星號與斜線的意思
以下是 poyin_db.txt 裡的實際資料:
[仔] ㄗˇ
[仔] ㄗㄞˇ    打*/牛*/公*/豬*
[會] ㄏㄨㄟˋ
[會] ㄎㄨㄞˋ  *計/管*
[會] ㄏㄨㄟˇ  一*
[會] ㄍㄨㄟˋ  *稽
* 代表這筆規則的目標漢字,/ 分隔不同詞彙。以仔為例,牛* 會對應牛仔,再選取 ㄗㄞˇ。星號不是任意字串萬用字元,也不是正規表示式;它是目標字的定位記號。
第一讀音的詞彙可以留空,因為沒匹配到規則時,原本沒有 IVS 的文字就維持預設字形。不過,第一讀音也可以列規則,讓介面把該字標成已猜測,提醒使用者確認。
拆解 JavaScript 的四個主要動作
index.html 直接載入 jQuery、poyin_db.js、ime.js 與字典介面。核心選音不需要後端 API,也沒有載入語言模型。
-
拆解文字並建立逐字編輯元素
setEditorText() 將輸入拆成內部的 text 陣列,嘗試把 UTF-16 surrogate pair、選擇子,以及自訂注音使用的後續字元保留在同一項,再替文字建立帶索引的 span。
若該字在 data 裡,就加上多音字的 p class;若資料另有 f 標記,再加上 fuzzy。已有選擇子的文字則標成已選擇或特殊自選。這套拆解方式是專案自己的實作,並不是通用的 Unicode grapheme 分段器。
-
用前後文比對詞彙
autoSelect() 逐項檢查 text,找到多音字後,巡覽該字的各讀音及詞彙列表,再呼叫 match()。比對程式先找到星號在詞彙中的位置,據此往前定位,擷取等長的文章片段。
例如處理牛仔的仔時,規則 牛* 的星號位於第二個位置,程式便檢查前一項與目前這項是否組成牛仔。吻合時,將目標項改寫為漢字加選擇子,並加入 auto class。
如果原文的這個字已帶有 IVS,autoSelect() 會設定 onlydic,繼續整理字典查詢資訊,但不覆寫原本的讀音。這是保護既有人工選音的行為,不代表程式已驗證該讀音符合上下文。
-
產生候選並處理手動選音
goNext() 負責前後移動與建立候選列。候選數量取自 data[c].s,每個候選用漢字搭配不同選擇子產生,點擊後就更新 text[curr]、把狀態改成 ok,再移到下一個多音字。
-
完成後串回文字
按下完成時,程式將 text 陣列串接起來,寫回 textarea 並呼叫 select()。它沒有在這一步產生 Word 檔,也沒有自動把內容寫入剪貼簿;使用者仍要自行複製。
字典則是另一套輔助功能:textinfo 記錄匹配到的詞彙,zhdicui.js 與 ToneOZ 字典元件再用這些資料查詢內附的字典。查字典的資料與自動選音詞庫有分工,不能把兩者的收錄量當成同一件事。
修改詞彙後,用 Ruby 重建網頁詞庫
瀏覽器載入的是 poyin_db.js,所以只修改 poyin_db.txt,重新整理網頁不會生效。正確流程是在儲存庫中修改文字詞庫,再執行產生器:
cd ime
ruby gen_jsdb.rb
# 先確認產生器實際修改了哪些內容
git diff -- poyin_db.txt poyin_db.js
README 把產生器寫成 poyin_db.rb,但本文版本實際的檔名是 gen_jsdb.rb。而且這個程式使用相對路徑讀檔,必須注意執行目錄。
產生器會從完整讀音表取得多音字與讀音順序,再合併人工詞彙規則;它也讀取 phonic_types.txt,建立自訂注音使用的 ruby 對照物件。最後輸出 var data = ... 與 var ruby = ...。
// poyin_db.js 中「會」的資料結構
"會": {
  "s": 4,
  "v": ["", "*計/管*", "一*", "*稽"]
}
s 是讀音數量,v 是依讀音順序排列的詞彙規則,索引 0 對應第一讀音;f 則是選用的易猜錯標記。前端不需要先解析整份原始讀音表,就能建立候選與執行比對。
我統計目前的 data,共有 3,235 個多音字項目,其中 534 個有詞彙規則。這不是完整讀音表的漢字總數,也不是字典詞條數,更不代表每個字的每種讀音都有自動判斷能力。
我另在獨立暫存目錄中,複製產生器及必要資料執行 Ruby,產出的 poyin_db.js 與儲存庫版本逐位元組相同。這項檢查確認本文版本的產生流程可重現,不需要因此重建字型。
這裡要留意副作用:產生器也會重寫 poyin_db.txt,不只輸出 JavaScript。程式遇到未知漢字或讀音時會印出 Error: 並略過該筆,因此不能只看結束碼判定資料正確;還要閱讀輸出並檢查差異。
實測選音結果與目前的限制
我在本機瀏覽器直接檢查 text 陣列、DOM class 與輸出碼位。以下使用選擇子的文字表示法,避免一般字型把差異隱藏:
| 輸入情境 | 實測結果 | 代表的行為 |
|---|
| 牛仔 | 牛仔 + U+E01E1 | 命中 牛*,仔選為第二讀音 |
| 開會 | 輸出碼位維持開會 | 沒有匹配規則,會維持預設第一讀音 |
會 + U+E01E2 + 計 | 原本的 U+E01E2 保留 | 已帶 IVS 的字不被自動選音覆寫,即使與詞彙預期不同 |
| 會計自動選音後,手動點第一候選 | 會後方的選擇子移除,class 改成 ok | 第一讀音使用裸字,手動狀態另由介面保存 |
| 一會計 | 一會 + U+E01E2 + 計 | 人工組合的衝突測試,同時命中 *計 與 一*,後者覆寫前者 |
最後一筆不是拿來評斷自然語句的正確發音,而是刻意讓兩條規則同時吻合,用來觀察程式的優先順序。
規則衝突時,不能假設第一筆命中就停止
讀 autoSelect() 時,很容易以為下面這行表示成功後立即跳出:
if (match(c, i, list[n], j, onlydic)) break here;
但 match() 失敗時會回傳 false,成功路徑卻只更新文字與字典資訊,沒有回傳 true,最後得到的是 undefined。因此,上面這個條件在成功時也不會成立,後續吻合的規則仍會執行。
所以目前不能把它描述為最長詞優先、第一筆命中優先,或有信心分數的語意判讀器。若要改寫這段演算法,必須先決定規則優先順序,再處理回傳值;單純加上 return true 也會改變既有結果。本文只分析行為,沒有修改工具。
有處理 surrogate pair,不代表所有路徑都完整支援
另一個邊界是非 BMP 漢字。程式有 unicharAt() 幫助取得代理對,但建立多音字標記、前後導航與部分比對仍使用 charAt(0)。
我確認 data 裡有 𣎴 這個字,資料標示兩個讀音。然而輸入 會𣎴 時,該字仍被標成一般字的 c class,而不是多音字的 p。這表示補充平面漢字的處理仍有不一致,不能因為輸入沒有破字就認定整套選音功能都正常。
對一、不變調、兒化、連接詞和,以及文言文,專案 README 也明列推測限制。目前主要靠詞庫列舉,沒有完整的下一字聲調推導或句法分析。橘色已猜測只表示程式命中規則,並不是讀音正確的保證。
使用特殊自選與注音留白
我查 README 時也看到另一個落差:文件仍寫工具尚未支援 U+E01E0 留白,但目前的 showDialog() 與選項事件已實作特殊自選。候選列最後一個項目會開啟對話框,包含注音留白、注音填空、自訂注音與漢字填空。
一般注音留白使用漢字加 U+E01E0;自訂注音則在這個序列後加上專案對應的 PUA 字元,由 ruby 物件取得碼位。注音填空使用的也是專案特定的組合。
這些功能適合教材排版,但它們比一般選音更依賴字型約定。自訂注音不是一串標準注音文字的同義表示;如果後續系統需要語音合成、語言分析或交換發音資料,應另外保存明確的注音或讀音欄位。
確認跨軟體複製與更換字型的結果
IVS 把選音存進文字,能降低讀音依賴文件格式的問題,但實務上仍要區分資料保留與顯示支援。依 Unicode 的說明,不支援某個變體序列時,通常會顯示基底字元並隱藏選擇子;這不等於畫面上能看見選音。
- 資料層:複製、儲存與傳輸是否保留選擇子,有沒有被清理程序移除。
- 字型層:目標字型是否支援同一套 bpmfvs 映射,並收錄該字與該讀音。
- 應用程式層:軟體的文字排版引擎是否正確處理序列及字型替代。
我會先用前面的碼位檢查確認資料,再檢查字型,而不是只靠肉眼判斷複製成功。至於資料庫比對、全文搜尋或去重,也要先決定是否把帶選擇子與不帶選擇子的文字視為相同,不能直接假設一般字串相等。
此外,手動選回第一讀音時輸出仍是沒有選擇子的漢字,綠色狀態只留在介面。因此將純文字重新貼回工具,不能要求它記得每一次人工確認。這和第二讀音以上有明確選擇子的情況不同。
總結
這套工具最值得理解的是它如何分配責任:JavaScript 提供選音與校對介面,Ruby 預先整理資料,IVS 把選擇結果放進文字,最後由注音字型顯示。這讓選音不必完全綁在某一份文件的字型格式設定上。
如果要改善自動選音,我會先從 poyin_db.txt 的詞彙與衝突案例著手,再檢查 match() 的回傳及優先順序。若要做可靠的發音資料交換,則應另外保存明確讀音,保留 IVS 作為排版輸出。把推測、資料與顯示分清楚,才知道出現錯音時應該修哪一層。
相關連結