最近我在整理「頁問」串接 Ollama Cloud 的 Token 用量資訊,先釐清了一個容易混淆的問題:使用 deepseek-v4.1-flash:1017 時,是不是一定要傳入 stream_options.include_usage: true,才拿得到輸入與輸出的 Token 數?
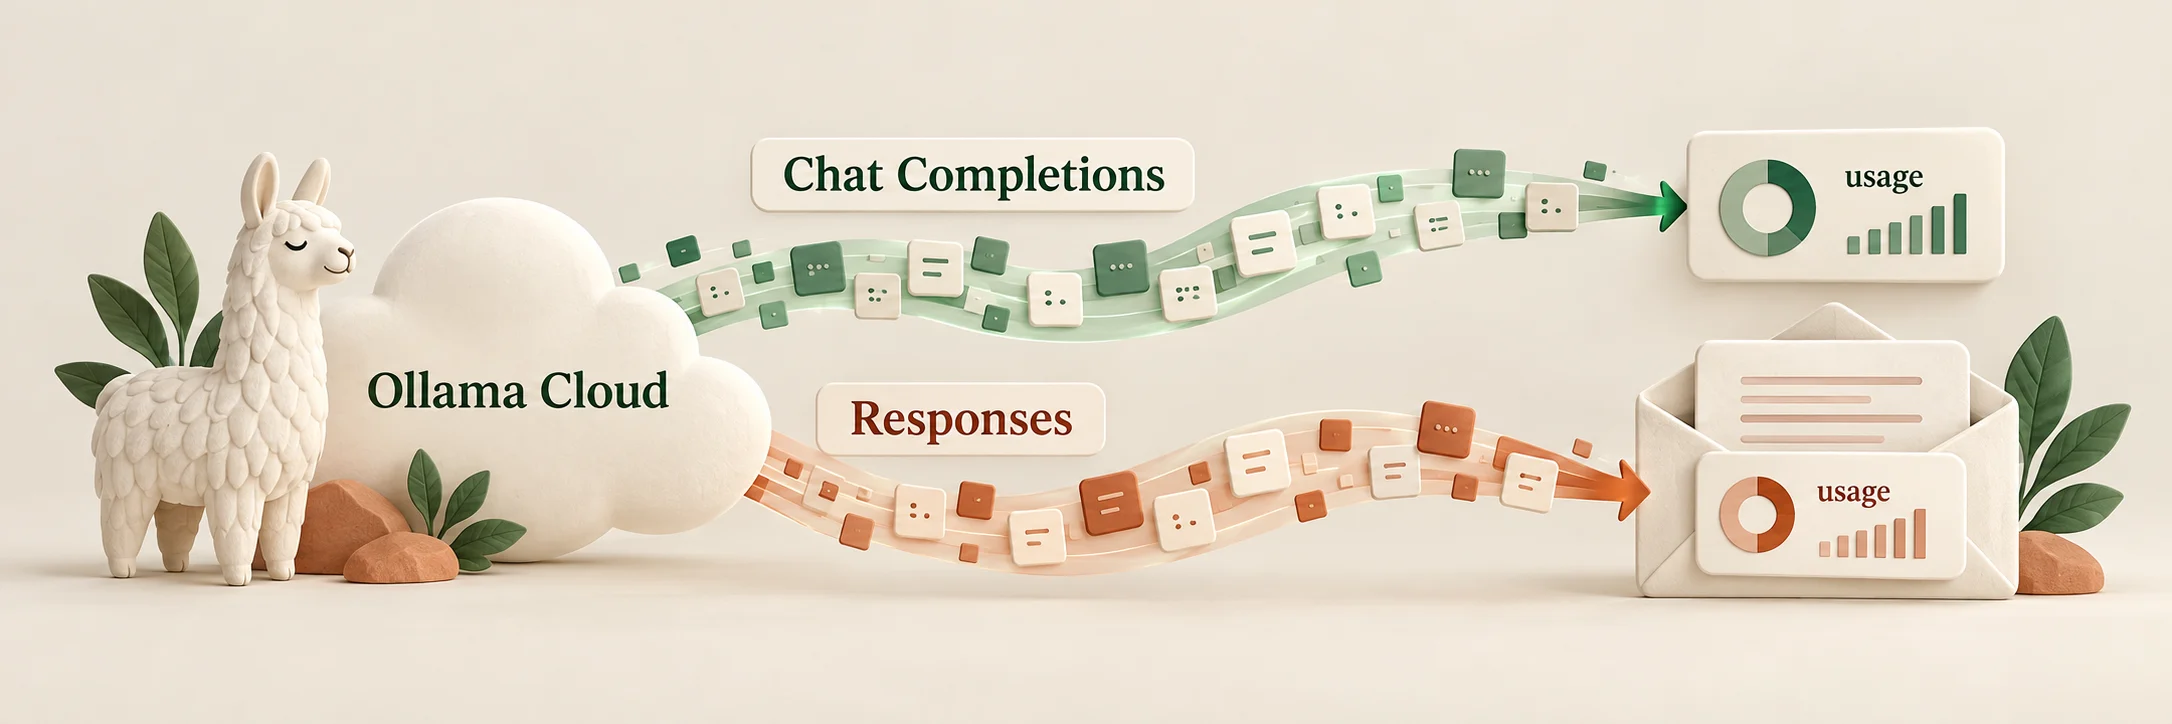
接著延伸到 Responses API,才發現這個問題不能只看模型名稱。同樣是串流回應,Chat Completions 與 Responses API 的用量回傳方式並不相同。如果把兩套 API 當成同一種格式處理,就可能收到完整回答,卻漏掉最後的用量資訊。
這篇文章整理我查核官方文件與原始碼後確認的差異,並提供請求與解析範例。重點是先辨識端點,再決定要送什麼參數,以及從哪個事件讀取用量。
先確認你呼叫的是哪一個 API
Chat Completions 串流應明確要求回傳用量;Responses API 則不需要 stream_options.include_usage,用量放在完成回應中。
我會先用下表判斷應該檢查哪一段程式:
| API 與模式 | 是否需要 stream_options.include_usage: true | 用量位置 | 輸入/輸出欄位 |
/v1/chat/completions
串流 | 需要明確設定 | 最後的用量區塊之 usage | prompt_tokens
completion_tokens |
/v1/chat/completions
非串流 | 不需要 | JSON 回應的 usage | prompt_tokens
completion_tokens |
/v1/responses
串流 | 不需要 | response.completed 事件的 response.usage | input_tokens
output_tokens |
/v1/responses
非串流 | 不需要 | JSON 回應的 usage | input_tokens
output_tokens |
原生 /api/chat,串流 | 不需要此參數 | done: true 的最後一筆物件 | prompt_eval_count
eval_count |
前三種用量格式不要混用。尤其 Responses 串流的取值路徑是 event.response.usage,並不是 event.usage。
依照 Ollama 的 OpenAI 相容性文件,直接呼叫雲端時,Base URL 使用 https://ollama.com/v1,也支援無狀態的 Responses 請求。不過,支援 OpenAI 相容介面並不代表所有 OpenAI 功能都能使用;目前文件仍列有雲端 Responses 的功能限制。
使用 Chat Completions 時,明確要求串流用量
假設已將 Ollama API 金鑰設定在 OLLAMA_API_KEY 環境變數,請求可以這樣寫:
curl --no-buffer --fail-with-body https://ollama.com/v1/chat/completions \
    -H "Authorization: Bearer ${OLLAMA_API_KEY}" \
    -H 'Content-Type: application/json' \
    -d '{
        "model": "deepseek-v4.1-flash:1017",
        "messages": [
            { "role": "user", "content": "請用一句話介紹 Ollama。" }
        ],
        "stream": true,
        "stream_options": {
            "include_usage": true
        }
    }'
這裡真正影響串流用量回傳的是 stream_options.include_usage。Ollama 在 Chat Completions 支援欄位中列出了這個選項;我會明確傳入,避免依賴 SDK 或中介服務替我補上參數。
回應中最後的用量區塊可能像這樣,以下僅保留重點欄位:
data: {"choices":[],"usage":{"prompt_tokens":20,"completion_tokens":12,"total_tokens":32}}

data: [DONE]
choices 是空陣列,仍然可能是一筆重要的用量回應。 如果程式一看到 choices.length === 0 就跳過,最後的統計就會被自己丟掉。
另一個細節是,文字輸出結束的 finish_reason 與用量區塊可能分開送達。收到 finish_reason 時就停止讀取,也可能漏掉後面的 usage。這個行為可從 Ollama 的 Chat Completions 串流轉換實作確認。
改用 Responses API 時,讀取完成事件
Responses API 的請求不必加上 stream_options.include_usage:
curl --no-buffer --fail-with-body https://ollama.com/v1/responses \
    -H "Authorization: Bearer ${OLLAMA_API_KEY}" \
    -H 'Content-Type: application/json' \
    -d '{
        "model": "deepseek-v4.1-flash:1017",
        "input": "請用一句話介紹 Ollama。",
        "stream": true
    }'
這套 API 使用具名的 Server-Sent Events(SSE,伺服器傳送事件)。文字增量與完成事件有不同的 type,完成事件中的用量格式如下,同樣只保留重點欄位:
event: response.completed
data: {"type":"response.completed","response":{"status":"completed","usage":{"input_tokens":20,"output_tokens":12,"total_tokens":32}}}
我查到的 Ollama Responses 實作會在 processCompletion 建立用量物件,再放進 response.completed 事件的 response 中,這段流程沒有以 include_usage 作為開關。
因此,如果 Responses API 的完成事件沒有用量,我會先檢查原始事件、SDK 與中介轉換流程,確認欄位是否被丟掉。加入 Chat Completions 的用量參數,並不是 Responses API 的標準解法。
讓解析程式分別處理文字與用量
下面示範的是 SSE 已經完成分幀、data 已解析成 JSON 之後的事件處理。它不是完整的網路串流解析器:單次 reader.read() 取得的資料,可能只有半筆事件,也可能包含多筆事件,不能直接對每次讀到的字串呼叫 JSON.parse()。
如果專案已有 SSE 解析器,我會在事件處理層保留 API 差異,再統一成應用程式使用的欄位:
let tokenUsage = null;

function handleChatCompletionChunk(chunk) {
    // 先處理用量,避免 choices 為空時漏掉統計。
    if (chunk.usage) {
        tokenUsage = {
            inputTokens: chunk.usage.prompt_tokens,
            outputTokens: chunk.usage.completion_tokens,
            totalTokens: chunk.usage.total_tokens
        };
    }

    const text = chunk.choices?.[0]?.delta?.content;
    if (typeof text === 'string') {
        console.log(text);
    }
}

function handleResponsesEvent(event) {
    if (event.type === 'response.output_text.delta') {
        console.log(event.delta);
    }

    if (event.type === 'response.completed' && event.response?.usage) {
        const usage = event.response.usage;
        tokenUsage = {
            inputTokens: usage.input_tokens,
            outputTokens: usage.output_tokens,
            totalTokens: usage.total_tokens
        };
    }
}
這兩個函式是兩種 API 的獨立處理入口,每次請求開始時都應重設 tokenUsage。Chat Completions 的 [DONE] 則交由外層 SSE 讀取流程辨識,不要當成 JSON 傳進來。
我會讓「尚未取得用量」保留為 null。如果一開始就填入 0,串流中斷、使用者取消,或服務沒有回傳統計時,畫面就會把未知用量顯示成零。
完整回答文字已到齊,不代表用量資訊也已到齊。 取消或中斷時可能收不到最後的統計,介面應顯示「未取得用量」,避免把缺少資料當成沒有消耗 Token。
使用原生 API 時,改看 Ollama 的計數欄位
如果呼叫的是原生 /api/chat,就不適用上述兩套 OpenAI 用量欄位。
Ollama 原生 Chat API 文件列出的欄位是:
prompt_eval_count:輸入 Token 數。eval_count:輸出 Token 數。done:是否已完成。
原生串流使用 NDJSON,每行是一筆 JSON。用量應從最後完成的物件讀取,不要套用 SSE 的 data: 或 event: 解析規則。若兩個計數都有提供,才將它們相加作為總 Token 數。
驗證時,同時檢查有資料與缺少資料的情境
實際整合時,我會先保存已遮蔽敏感資訊的原始回應,確認伺服器有沒有回傳用量,再對照應用程式解析後的結果。可以依照下表檢查:
| 情境 | 檢查重點 |
Chat Completions 串流,帶入 include_usage: true | 完整讀完,確認最後是否有 usage |
| Chat Completions 串流,省略該選項 | 記錄實際行為;SDK 或代理可能自動補入,不能只看呼叫端程式碼判斷 |
Chat Completions 用量區塊的 choices 為空 | 仍須保存用量 |
Responses 串流,未加入 include_usage | 確認 response.completed.response.usage |
| Responses 非串流 | 確認 JSON 根層的 usage |
| 使用者取消,或未收到最終用量就斷線 | 保留未知狀態,不能顯示成零 |
| 連續發出兩次請求 | 第二次不能沿用第一次的統計 |
這份表格是後續實測清單,並不是本文已完成的測試紀錄。若要確認特定模型與端點的實際行為,仍須使用自己的帳號執行請求。
總結
這次整理最值得記錄的地方,是取得 Token 用量需要同時對齊請求設定與回應解析方式。對 Ollama 的 Chat Completions 串流,我會明確設定 stream_options.include_usage: true,並持續讀取到最後的用量區塊。
改用 Responses API 時,就直接處理 response.completed 中的 response.usage。兩套 API 的欄位名稱也不同,要分別讀取後再轉成應用程式的共用格式。
相關連結